 Yutao Liu
测试智能体:用 AI 搭一套能长期跑下去的自动化测试体系
用编程智能体补单元测试、生成接口测试、写端到端 UI 用例、分析流水线失败和治理不稳定用例;每层给出派活提示与验收标准,并列出智能体写测试时最常见的几种「作弊」,以及哪些决定必须留给人。
目录
先分层:智能体在每一层能干什么 测试的验收标准:四个问题 场景一:给老代码补单元测试(Plan 必做) 场景二:从接口文档生成接口测试 场景三:端到端 UI 测试 场景四:从需求生成测试用例 场景五:流水线失败分析和不稳定用例治理 智能体写测试时最常见的六种「作弊」 接入流水线:分层设置门禁 我的实践:自己搭的「质量门户」 不该交给智能体的决定 一个完整例子:两周搭起回归测试 延伸阅读系列第四篇。选型见 智能体不只是聊天,派活顺序见 派活与验收,研发链路见 研发智能体。上一篇把测试当作「修 Bug 的验收手段」;这一篇反过来,把 测试体系本身 当作要交付的东西。
很多团队的自动化测试都卡在同一个地方:知道该写,没人有空写;好不容易写了,半年后没人维护,流水线里一片红,最后干脆关掉。
编程智能体在这里很有用,因为写测试是典型的「步骤多、规则清楚、但很枯燥」的活。但它也有一个危险的特点:智能体非常擅长让测试变绿。 让测试变绿和让测试有用,是两回事。
所以这篇文章的核心只有一句:测试也要被验收。
先分层:智能体在每一层能干什么
自动化测试常见的分层,以及智能体在每层的适合程度:
| 层级 | 测什么 | 常用工具 | 智能体适合程度 |
|---|---|---|---|
| 单元测试 | 单个函数、类的逻辑 | Jest、Vitest、pytest、JUnit、Go test | 很适合:上下文小,结果可验证 |
| 接口测试 | HTTP 接口的入参、出参、状态码 | pytest + requests、Apifox、MeterSphere | 适合:有接口文档时效率很高 |
| 端到端 UI 测试 | 用户在页面上的完整操作流程 | Playwright、Cypress、微信小程序的 miniprogram-automator、Appium | 有条件适合:需要稳定的页面元素标识 |
| 性能测试 | 并发、响应时间、吞吐量 | JMeter、阿里云 PTS、k6 | 适合写脚本和分析报告,不适合决定压测方案 |
| 测试用例设计 | 从需求推导该测哪些情况 | TAPD、禅道、飞书多维表格里的用例表 | 很适合:边界值、异常路径列得比人全 |
| 失败分析 | 流水线红了,是产品问题还是用例问题 | GitLab CI、云效、Jenkins 的日志 | 很适合:读日志、归类、给出初步判断 |
一个经验:越靠近代码,智能体越可靠;越靠近真实用户环境,越需要人把关。 单元测试可以大量交给它,端到端测试要人设计主流程、它来写实现。
测试的验收标准:四个问题
智能体交付了一批测试,全绿。先别高兴,问四个问题:
1. 这个测试会失败吗?
一个永远不会失败的测试没有任何价值。验证方法很简单:故意把被测代码改坏,看测试是否变红。
可以直接让智能体做这一步:
对你刚写的 tests/order/test_discount.py,做一次「破坏验证」:
1. 依次把 calc_discount 函数里的关键逻辑改错(比如把 >= 改成 >,把折扣率改成 1)
2. 每改一处,运行测试,记录是否有测试失败
3. 全部还原,确认 git diff 中业务代码没有残留改动
4. 输出表格:改动点、是否被测试发现、发现它的测试名
这在测试领域叫「变异测试」,也有专门工具(如 Stryker、mutmut)可以自动做。没被发现的改动点,就是测试的漏洞。
2. 断言在检查真正重要的东西吗?
常见的低质量断言:
- 只检查「没有抛异常」或「返回值不为空」
- 只检查状态码 200,不检查返回内容
- 断言的期望值是从被测代码的输出复制过来的(等于用代码验证代码自己)
3. 测试稳定吗?
同一份代码连续跑 10 次,结果是否一致。时好时坏的测试叫「不稳定用例」,它比没有测试更糟,因为它会让所有人习惯性地忽略红色。
4. 覆盖率数字说明了什么?
覆盖率只说明代码 被执行过,不说明 被检查过。一个只调用函数、不写断言的测试,也能把覆盖率拉到 100%。覆盖率可以作为参考,不要作为给智能体的唯一目标。如果你只说「把覆盖率提到 80%」,它很可能就交给你一堆没有断言的测试。
场景一:给老代码补单元测试(Plan 必做)
难点
老代码没有测试,也没有文档,当前行为是对是错往往说不清。这时候的目标不是「验证代码正确」,而是 把当前行为固定下来,以后重构时一改就能发现。这类测试叫「特征测试」或「行为锁定测试」。
怎么派活
【模式】先 Plan,我确认后再写测试。不要修改 src/ 下的任何业务代码。

【目标】为 src/billing/ 模块补单元测试,用于以后重构前锁定当前行为。

【计划里要写清】
1. 你打算测哪些函数,按「业务重要性」排序(金额计算、状态流转优先)
2. 每个函数要测的情况:正常值、边界值、异常输入
3. 哪些依赖需要模拟(数据库、外部接口),模拟到什么程度

【规则】
- 如果发现当前行为看起来像 Bug,不要改代码,也不要把测试写成「期望正确行为」;
  按当前行为写测试,并在 tests/billing/疑似问题.md 里记录
- 不要模拟被测函数本身
- 每个测试名要能说明测的是什么,例如 test_满100减20_刚好100元时生效
怎么验收
- [ ] 对金额计算类函数做一次「破坏验证」,关键逻辑改错时测试会失败
- [ ] 打开
疑似问题.md,逐条判断:真是 Bug 的,另开任务修 - [ ] 模拟没有过度:如果一个测试里所有东西都是模拟的,它测的只是模拟本身
「疑似问题」那份清单往往是这类任务最有价值的副产品。智能体逐行读老代码,常会发现没人注意过的边界问题。
场景二:从接口文档生成接口测试
前提
接口测试最怕「文档和实现对不上」。国内团队常用 Apifox、YApi、Swagger 维护接口定义,先确认这份定义是最新的。如果不是,先按上一篇的「文档同步」场景以代码为准更新文档。
怎么派活
【目标】根据 docs/openapi.yaml(从 Apifox 导出),为「订单」相关的 6 个接口生成接口测试,
放在 tests/api/order/,使用 pytest + requests。

【每个接口至少覆盖】
1. 正常请求:检查状态码、返回字段、字段类型、关键字段的值
2. 参数缺失、类型错误、超出范围
3. 未登录、无权限
4. 业务异常:库存不足、订单已取消后再支付等

【测试数据】
- 每个测试自己准备数据、自己清理,测试之间不能互相依赖
- 不要依赖测试环境里已有的某条数据
- 测试账号和地址从环境变量读取,不要写死在代码里

【约束】只能连测试环境,配置里如果出现生产地址立即停下告诉我。
怎么验收
- [ ] 随机打乱顺序运行(pytest 可用
pytest-randomly),结果不变,说明用例之间没有隐藏依赖 - [ ] 连续运行两遍,第二遍不会因为「数据已存在」而失败,说明清理做到位了
- [ ] 断言检查了返回内容,不只是状态码
- [ ] 代码里没有任何账号、密码、令牌、生产地址
最后一条要特别检查。智能体为了让测试快速跑通,有时会把你在对话里贴过的测试账号直接写进代码。
场景三:端到端 UI 测试
先解决「元素怎么找」
UI 测试不稳定,八成是因为元素定位方式太脆弱:按 CSS 类名、按第几个 div、按页面文字。页面一改版,测试就全挂。
比较稳的做法是在页面上给关键元素加专门的测试标识,比如 data-testid。这一步可以先让智能体做:
【目标】为下单流程的 4 个页面(商品详情、购物车、确认订单、支付结果)
给关键交互元素加上 data-testid 属性。

【规则】
- 只加属性,不改任何样式、逻辑、文案
- 命名格式:页面-元素-动作,例如 cart-checkout-button
- 输出一份清单 tests/e2e/testid-清单.md,方便写测试时查
再写测试
主流程由人来定,智能体负责实现。比如你规定「游客浏览 → 登录 → 加购 → 下单 → 支付成功」这一条主线:
【目标】用 Playwright 写下单主流程的端到端测试,放在 tests/e2e/checkout.spec.ts。

【流程】(不要增减步骤)
1. 打开商品详情页,点击加入购物车
2. 弹出登录,用测试账号登录
3. 进入购物车,点击结算
4. 确认订单页检查金额,提交订单
5. 支付使用测试环境的模拟支付,检查结果页显示「支付成功」

【规则】
- 只用 data-testid 和可访问性角色(按钮、输入框)定位元素
- 不要用固定时间等待(sleep、waitForTimeout),用等待元素出现或网络请求完成
- 每一步失败时自动截图
生成的代码大致是这样(节选):
test("游客登录后完成下单", async ({ page }) => {
  await page.goto("/product/1001");
  await page.getByTestId("product-add-cart-button").click();
  await loginWithTestAccount(page);
  await page.getByTestId("cart-checkout-button").click();
  await expect(page.getByTestId("order-total-amount")).toHaveText("¥199.00");
  await page.getByTestId("order-submit-button").click();
  await expect(page.getByTestId("pay-result-title")).toHaveText("支付成功");
});
小程序和 App
- 微信小程序:官方提供
miniprogram-automator,可以通过开发者工具驱动小程序完成点击、输入、读取页面数据,思路和上面一致。 - App:Appium 仍是最常用的方案,元素标识对应安卓的
resource-id和 iOS 的accessibilityIdentifier。
用自然语言描述操作的 UI 测试
还有一类新做法:不写选择器,直接用自然语言描述「点击右上角的购物车图标」,由视觉模型在截图上找元素,比如字节开源的 Midscene.js。它适合页面经常变、加测试标识成本高的场景,但每一步都要调用模型,运行慢、有成本、结果也不是百分之百确定。目前更适合做补充,主流程回归仍建议用稳定标识。
怎么验收
- [ ] 代码里没有固定时间等待
- [ ] 连续运行 10 次全部通过
- [ ] 故意让某一步失败(比如把测试账号密码改错),失败信息和截图能让人一眼看出是哪一步出了问题
场景四:从需求生成测试用例
什么时候用
产品在 TAPD、禅道或飞书文档里写好需求,测试同学要据此设计用例。这一步智能体很擅长,因为它会系统地列边界值和异常路径,不容易漏。
怎么派活
【材料】需求文档:需求/优惠券叠加规则.md

【目标】输出测试用例表 用例/优惠券叠加.xlsx,列:编号、模块、前置条件、操作步骤、预期结果、优先级、用例类型(正常/边界/异常)

【要求】
1. 用等价类和边界值方法,金额、数量、时间相关的规则都要有边界用例
2. 需求里没写清楚的地方,不要自己假设,单独列在「需求待澄清」sheet 里
3. 标出哪些用例适合自动化,哪些建议手工测
怎么验收
- 重点看「需求待澄清」:这份清单拿去和产品对一遍,经常能在开发前就发现需求漏洞,比测出 Bug 再返工划算得多。
- 抽查高优先级用例:预期结果是否和需求原文一致,而不是智能体「觉得合理」的结果。
- 「适合自动化」的用例,可以接着交给场景二、场景三去实现,形成从需求到自动化脚本的链路。
场景五:流水线失败分析和不稳定用例治理
失败分析
流水线红了,第一件事是判断属于哪一类:
| 类型 | 表现 | 谁来处理 |
|---|---|---|
| 产品缺陷 | 代码改动导致功能出错 | 提交代码的开发 |
| 用例问题 | 需求变了,测试没跟着改 | 维护测试的人 |
| 环境问题 | 测试环境挂了、数据被别人改了、网络超时 | 负责环境的人 |
| 不稳定用例 | 同一份代码重跑就过了 | 维护测试的人,需要专门治理 |
这一步交给智能体很合适:
【模式】只读分析,不要修改任何代码。

【材料】最近一次流水线的失败日志 ci-logs/pipeline-8812.log,以及本次合并请求的 diff

【目标】对每个失败的测试,判断属于:产品缺陷 / 用例问题 / 环境问题 / 不稳定用例,
给出依据(日志行号、相关代码改动),以及建议谁来处理。
拿不准的标「需人工判断」。
不稳定用例治理
不稳定用例最常见的原因:固定时间等待、用例之间共享数据、依赖当前时间或随机数、依赖外部服务。
可以定期让智能体做一次体检:
读取最近 30 天流水线的测试结果(ci-history/ 下的 JUnit XML 报告),
找出「同一份代码时过时不过」的测试,按失败频率排序,
对前 5 个分析可能原因,并给出修复方案。先只给方案,不要修改。
怎么验收
- 对智能体给出的分类抽查几条,尤其是被判为「环境问题」的。把产品缺陷误判成环境问题,是最危险的错误,因为会被直接重跑放过。
- 不稳定用例修完后,连续跑 20 次以上确认真的稳定了。
智能体写测试时最常见的六种「作弊」
这一节最重要。下面这些不一定是智能体故意的,而是它在「让测试通过」这个目标下很自然会走的捷径。审 diff 时逐条对照:
| 作弊方式 | 长什么样 | 怎么发现 |
|---|---|---|
| 改断言迁就代码 | 测试失败后,把期望值改成代码的实际输出 | 看测试文件的 diff,断言的期望值有没有被改 |
| 跳过测试 | 加上 skip、xit、@Disabled、pytest.mark.skip | 全文搜索这几个关键字 |
| 模拟掉被测对象 | 被测函数本身被模拟了,测试只是在测模拟 | 看模拟的对象是不是就是被测的那个 |
| 吞掉异常 | 用 try/catch 包住断言,失败也不报错 | 搜索测试文件里的 try、catch、except |
| 加长等待 | 不稳定就加 sleep(5),问题被掩盖而不是被解决 | 搜索 sleep、waitForTimeout |
| 无脑更新快照 | 快照测试失败就重新生成快照 | 看快照文件的 diff 是否符合预期改动 |
在派活约束里可以直接写明:
不允许:修改已有测试的断言期望值、跳过任何测试、模拟被测函数本身、
用 try/catch 包裹断言、加入固定时间等待、更新快照文件。
如果你认为必须做其中某一项,停下来说明理由,等我确认。
接入流水线:分层设置门禁
测试写好了,要接进 GitLab CI、云效或 Jenkins 才能长期发挥作用。推荐按速度分层:
| 时机 | 跑什么 | 耗时目标 | 失败了怎么办 |
|---|---|---|---|
| 每次提交 | 单元测试、代码检查 | 5 分钟内 | 阻止合并 |
| 合并到主干前 | 单元 + 接口测试 | 15 分钟内 | 阻止合并 |
| 每晚定时 | 端到端 UI 测试全量 | 不限 | 第二天早上通知到飞书或钉钉群,指定人处理 |
| 发版前 | 全量回归 + 关键路径性能测试 | 不限 | 由负责人决定是否放行 |
流水线配置文件本身也可以让智能体写,但要注意:它会倾向于把失败的步骤设成「允许失败」来让流水线变绿(比如 GitLab CI 的 allow_failure: true)。审配置时看一眼这个字段。
我的实践:自己搭的「质量门户」
上面讲的都是方法。下面是我自己做的一个测试平台,叫「质量门户」,把前面几节的东西收到了一个界面里。
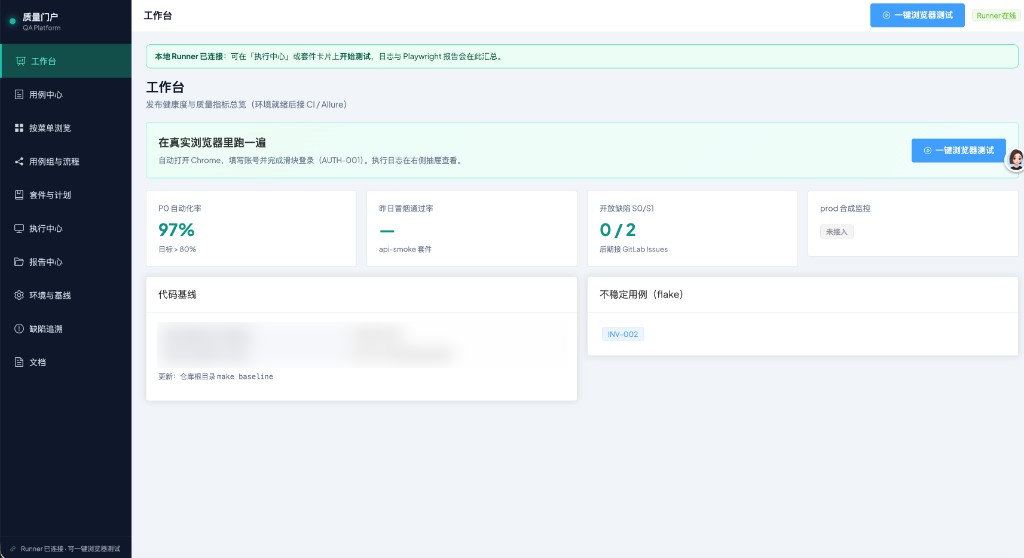
左侧菜单:对应测试工作的几个环节
| 菜单 | 做什么 | 对应本文哪一节 |
|---|---|---|
| 用例中心、按菜单浏览 | 管理测试用例;可以按产品的菜单结构浏览,快速看到某个页面有哪些用例 | 场景四:从需求生成测试用例 |
| 用例链与流程 | 把单个用例串成业务流程,比如先登录、再下单、再支付 | 场景三:端到端主流程 |
| 套件与计划 | 把用例组合成套件(比如接口冒烟套件 api-smoke),安排什么时候跑 | 接入流水线:分层门禁 |
| 执行中心 | 发起测试、查看执行日志 | — |
| 报告中心 | 汇总 Playwright 的测试报告 | 场景三 |
| 环境与基线 | 记录测试跑在哪个环境、哪个代码版本上 | 见下文「代码基线」 |
| 缺陷追溯 | 测试发现的问题关联到缺陷单 | 场景五:失败分析 |
| 文档 | 平台自己的使用说明 | — |
工作台上的四个指标
工作台首页只放四个数字,都是为了回答「这个版本能不能发」:
- P0 自动化率:最高优先级的用例里,有多少已经自动化。截图里是 97%,目标是 80% 以上。我只盯 P0,没有追求全量用例的自动化率,因为 P0 是每次发版都必须验证的部分。
- 昨日冒烟通过率:每天跑一次接口冒烟套件的结果。
- 开放缺陷 S0/S1:还没关闭的最严重两级缺陷,计划接到 GitLab Issues 上自动统计。
- 线上合成监控:用脚本模拟用户在生产环境定时访问关键页面,发现线上问题。
截图里「昨日冒烟通过率」还是空的、合成监控显示「未接入」,因为这两项要等测试环境稳定后,接上持续集成和 Allure 报告才有数据。指标先占位、数据后接入,比等全部做完再上线更实际:大家先习惯看这个页面,数据一项一项补。
一键浏览器测试和本地执行器
右上角的「一键浏览器测试」会在本机打开一个真实的 Chrome,自动填写测试账号、完成滑块验证登录(对应用例编号 AUTH-001),然后按用例往下执行。执行日志在右侧抽屉里实时显示,跑完的 Playwright 报告自动汇总到报告中心。
浏览器跑在本机而不是服务器上,是通过一个本地执行器(页面上显示的 Runner)连到平台。这样做有两个好处:
- 能看着它跑。端到端测试出问题时,亲眼看到卡在哪一步,比事后看截图快得多。
- 能用本机网络访问内网测试环境,不需要先把测试环境开放给服务器。
代码基线:测试结果对应哪个版本
「代码基线」一栏记录了前端和后端仓库当前对应的分支和提交号(截图里涉及内部仓库名,已做模糊处理),在仓库根目录执行 make baseline 更新。
这一栏解决的是一个很常见的扯皮:测试说「昨天测过是好的」,开发说「我今天才提交的修复」,到底测的是哪个版本?有了基线,每次测试结果都能对应到具体的前后端提交,出问题时可以直接对比两次基线之间改了什么。
不稳定用例单独列出
右下角「不稳定用例」专门列出时过时不过的用例,截图里有一个 INV-002。把它们单独放在首页,是为了不让它们混在普通失败里被反复重跑放过,对应前面「不稳定用例治理」那一节。
平台在测试体系里的位置
回头看这个平台,它本身不写测试、也不判断对错。它做的是三件事:把用例、执行、报告、缺陷放在同一个地方;让每次测试结果能追溯到代码版本;把需要人决定的事情(发不发版、哪个失败要修)摆到首页上。
测试用例和脚本可以大量交给智能体写,但「这些测试是否足够、这个版本能不能发」,需要一个让人看得清楚的地方来判断。这就是我做这个平台的原因。
不该交给智能体的决定
- 测什么、不测什么:测试策略和优先级取决于业务风险,这是人的判断。
- 上线放行:测试报告可以由智能体整理,但「这个版本能不能发」由负责人决定。
- 在生产环境压测:方案、时间、影响范围必须人工评审,智能体只写脚本和分析结果。
- 修改「需求待澄清」里的预期:那些问题要找产品确认,不能让智能体替产品做决定。
- 删除测试:任何删除测试的改动都要人确认,哪怕看起来「这个测试已经没用了」。
一个完整例子:两周搭起回归测试
虚构但典型。某电商小程序团队,3 个开发、1 个测试,之前只有手工回归,每次发版测试要花两天。
| 时间 | 做了什么 | 交付物 |
|---|---|---|
| 第 1~2 天 | 测试同学定下主流程:浏览、加购、下单、支付、退款五条线 | 主流程清单(人工) |
| 第 2~3 天 | 智能体从需求文档生成用例表,标出适合自动化的部分;测试同学和产品过「需求待澄清」,发现两处规则冲突 | 用例表 + 2 个需求修正 |
| 第 3~5 天 | 智能体给订单、优惠券、库存三个核心模块补单元测试,做破坏验证,补强了 4 处没测到的逻辑 | 约 120 个单元测试 + 疑似问题清单(其中 1 个是真 Bug) |
| 第 5~7 天 | 智能体根据 Apifox 导出的接口定义生成接口测试,开发审 diff 时发现它在一处写死了测试账号,打回重做 | 约 60 个接口测试 |
| 第 7~9 天 | 开发给页面加 data-testid,智能体用 miniprogram-automator 写五条主流程的端到端测试 | 5 个端到端测试 |
| 第 9~10 天 | 智能体写 GitLab CI 配置,分三层门禁;审配置时去掉了一处 allow_failure | 流水线配置 |
| 第 11~14 天 | 连续跑,治理出 3 个不稳定用例(两个是固定等待,一个是用例间共享购物车数据) | 稳定的每晚回归 |
两周后的效果:发版前的手工回归从两天缩短到半天,只测新功能和自动化覆盖不到的部分。
注意人在哪些地方起了作用:
- 定主流程、和产品澄清需求:方向由人定。
- 审 diff 时发现写死账号、
allow_failure:这两处如果放过去,一个是安全隐患,一个会让门禁形同虚设。 - 疑似问题清单里挑出真 Bug:智能体负责发现,人负责判断。
延伸阅读
后续计划:项目管理、销售与售前、学习与资料整理等场景会陆续单独成篇。